Gate GEMM 中的L2复用优化和小batch矩阵transpose优化
Gate GEMM L2 复用优化
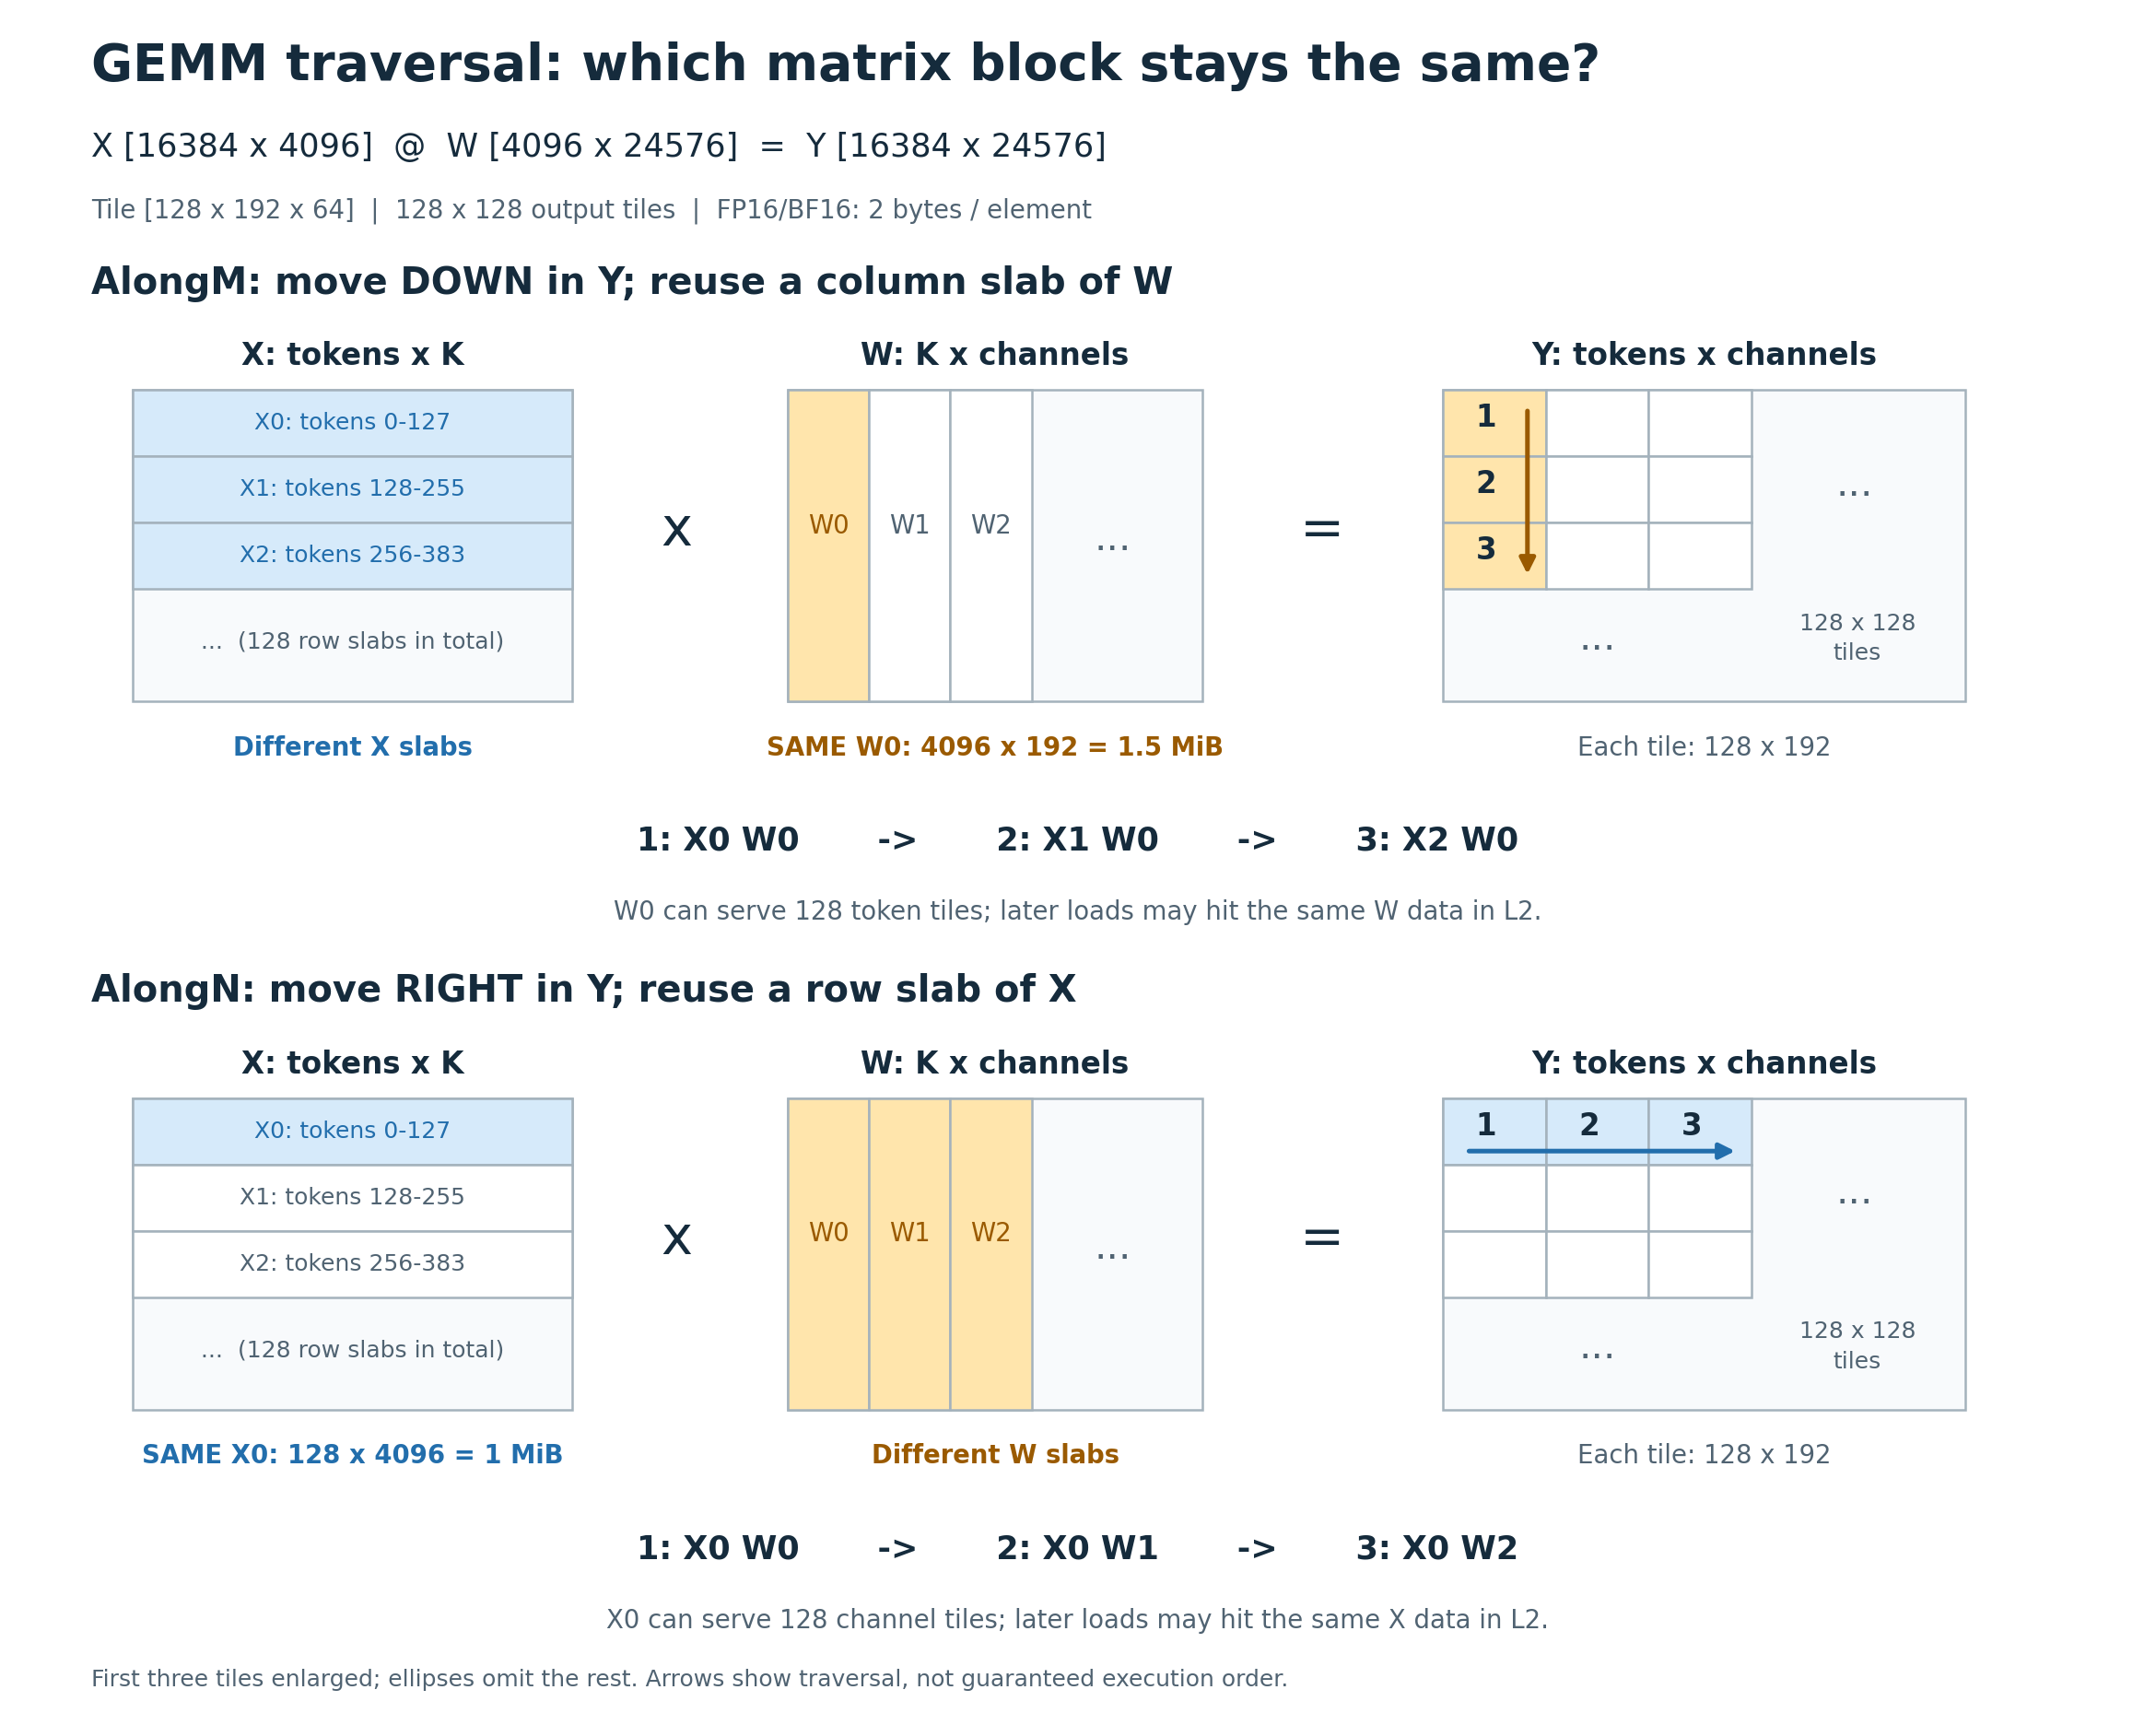
场景:FFN 将 gate/up 合并为 X[M,K]×W[K,N],再融合 SwiGLU。取 M=16384、K=4096、N=24576;这里 N 是激活前宽度。以下假设 FP16/BF16,每元素2字节。
X 共128 MiB,W 共192 MiB。tile=(128,192,64),输出网格为128×128,每个 CTA 沿 K 迭代64轮。
改变哪一维,就复用另一侧的数据
沿 token/M 遍历(AlongM):换 X,复用 W。沿输出通道/N 遍历(AlongN):换 W,复用 X。不要把“沿 X 方向切”和“复用 X”混为一谈。
| 项目 | AlongM:复用 W | AlongN:复用 X |
|---|---|---|
| 每轮 K 的共享块 | 64×192×2=24 KiB | 128×64×2=16 KiB |
| 跨完整 K 的共享块 | 4096×192×2=1.5 MiB | 128×4096×2=1 MiB |
| 使用同一块的 CTA 数 | 128 | 128 |
| 首次读取外的复用次数 | 127 | 127 |
| 每块理想省下的 HBM 读取 | 190.5 MiB | 127 MiB |
| 不同共享块数量 | 128 | 128 |
| 全 GEMM 理想累计节省 | 23.8125 GiB | 15.875 GiB |
这些节省量以“每个 CTA 都从 HBM 重读”为基线,假设被优先复用的一侧全部命中 L2。它们是累计流量,不是所需缓存容量;完整 K 的块也不必同时驻留 L2。

总读取量如何变化?
完全没有跨 CTA 复用时,X 读16 GiB,W 读24 GiB。若仅让优先复用的一侧完美命中:
- AlongM:16 GiB+192 MiB=16.1875 GiB。
- AlongN:128 MiB+24 GiB=24.125 GiB。
这个模型下,AlongM 少读7.9375 GiB。两侧复用次数相同,W 块大50%,所以复用 W 的理想节省量也大50%。实际两侧都可能部分命中,不能据此直接推断加速比。
N=192 又贡献什么?
tile N 从128增至192,N方向的 tile 数从192降为128;全 GEMM 的 X 加载需求从24降至16 GiB,尚未计缓存复用。更宽 tile 在 CTA 内多用输入,AlongM 在 CTA 间多用权重。最终仍需结合 L2 命中率、HBM 流量及耗时验证。
小batch矩阵优化
在 LLM decode 中,每个请求每轮只处理一个 token,因此小 batch 的矩阵乘法容易出现计算资源浪费。
以 B=1 的 FFN down 投影为例:
它把一个 token 的 12288 维特征映射成 4096 维。这里的“输出通道”就是输出特征维度:4096 个通道,对应输出向量中的 4096 个数。
假设原实现每个 CTA 使用 128 token × 128 输出通道 的 tile。实际只有一个 token,因此 tile 中只有一行有效。即使越界结果不写回,固定形状的矩阵指令仍会覆盖大量无效位置。
为什么不能直接把 tile 改成 1 × 128?因为硬件不支持任意计算形状。支持形状如下:
| 输入类型 | M | N 的可选值 | K |
|---|---|---|---|
| FP16 / BF16 | 64 | 8~256,步长 8 | 16 |
| TF32 | 64 | 8~256,步长 8 | 8 |
| FP8(E4M3 / E5M2) | 64 | 8~256,步长 8 | 32 |
| INT8 / UINT8 | 64 | 8、16、24,以及 32~256、步长 16 | 32 |
| 单比特 b1 | 64 | 同 INT8 | 256 |
于是,可以利用:
把输出通道放到 M 方向,把 token 放到可以缩窄的 N 方向,并选择 128 输出通道 × 8 token 的 tile减少浪费。
收益来自交换方向后能选用更小的 tile。如果只是把同一个矩形转过来,计算量不会减少。
这种改写也不必额外搬运或变换整个矩阵:在布局支持的实现中,可以通过操作数解释、shape/stride 和输出索引完成,无需单独的转置 kernel。
不过,权重仍需读取,整体加速还受访存、归约等开销影响。减少16倍计算位置,不等于运行速度提升16倍。这个优化的核心,是让小 batch 更好地适配硬件允许的计算形状。
Comments
No comments yet.